Download the Applications
पाइथन, उपग्रह डेटा र मशीन लर्निङ्ग सँग शहरी ताप द्वीप खोजीकर्ता निर्माण गर्ने
Catégorie: Technologie scientifique
Partager
Archive
J’aime
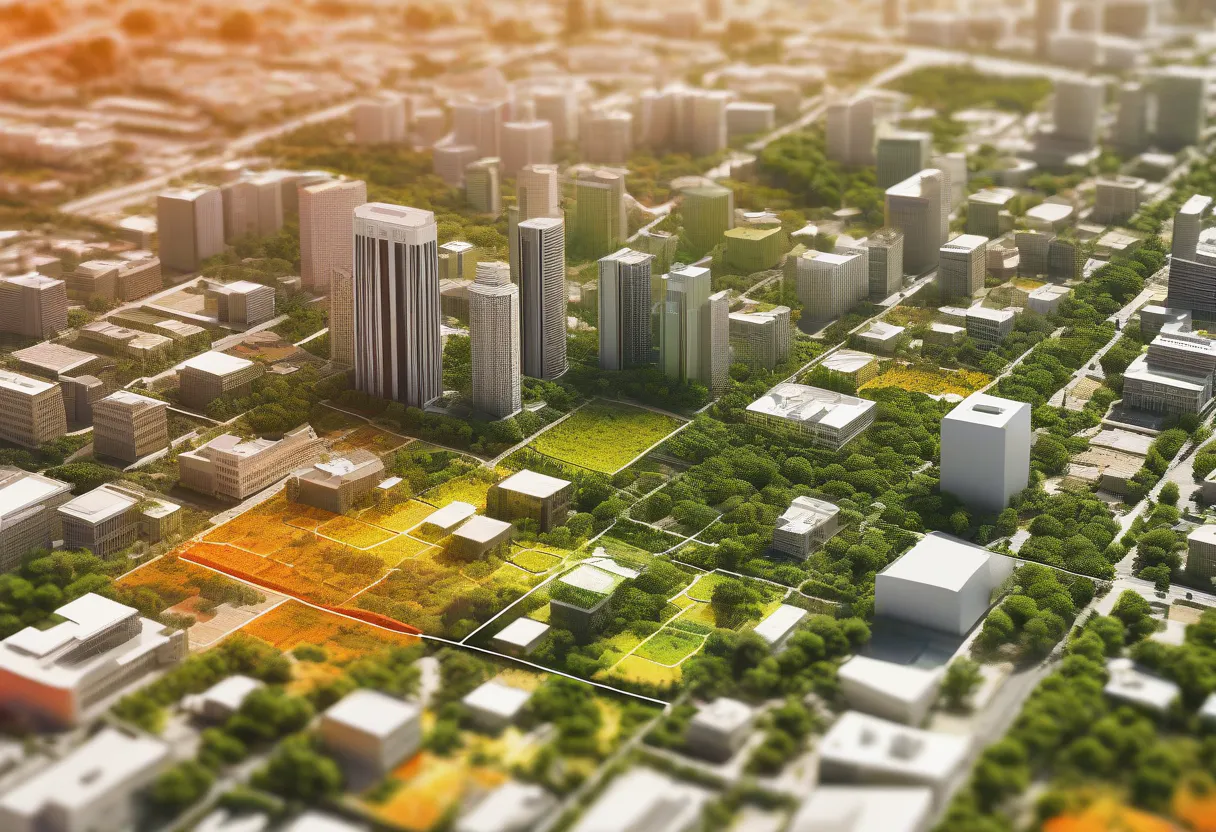
प्रत्येक गर्मीमा, शहरहरू आसपासको गाउँमा तुलनात्मक रूपमा गर्म हुन्छन्। यो केवल एक अनुभव होइन; यो मापनीय घटना हो जुन शहरी गर्मीको द्वीप (UHI) प्रभाव भनिन्छ, जहाँ कन्क्रीट, आस्फल्ट र घन इमारतहरू ग्रीन स्पेस र पानीका शरीरहरू अन्यथा बिसर्जन गर्न सक्छन् [1]। UHI गर्मी लहरहरूको समयमा उच्च ऊर्जा लागत, खराब हवा गुणस्तर र वास्तविक सार्वजनिक स्वास्थ्य जोखिमको साथ जुडेको छ।
म एक डेटा विश्लेषक हुँ, र म विश्वविद्यालय स्तरमा मशीन लर्निंग मा व्याख्यान दिन्छु, त्यसैले यो प्रकारको प्रश्न म अपनो कामको बाहिर खेल्न चाहन्छु: के हामी मुक्त उपग्रह डेटा र एक आम मशीन लर्निंग पाइपलाइनको उपयोग गरेर कुनै पनि शहरमा हिट द्वीपहरू मानचित्रण गर्न सक्छौं, लागतपूर्ण संपत्ति साधनहरू बिना?
उत्तर हो, र यो लेख ठीक कसरी गर्ने भन्ने बारे सम्पूर्ण विवरण दिन्छ, पायथन, खुला उपग्रह छवि र एक हल्का प्रतिगमन मोडेलको साथ। म आफैं एक सिमुलेटेड शहर ग्रिडमा पूर्ण पाइपलाइन चलाएको छु जुन लेखन अघि नीचे दिएका सबै चरणहरूको ताजा परीक्षण गर्नका लागि; जहाँ म यथार्थता नम्बरहरू संदर्भित गर्छु, तिनीहरू एक पाठ्यपुस्तकबाट आएका हैन, तर मेरो चलाएको चलानबाट आएका हैन।
यो एकimport ee
import geemap
ee.Initialize()
# परिसरको लागि क्षेत्र (उदाहरण: एक शहरको बाउन्डिंग बक्स)
aoi = ee.Geometry.BBox(-0.51, 51.28, 0.33, 51.68) # लन्डन, उदाहरणका लागि
# तापीय डेटा को लागि ल्यान्डसैट 9
landsat = (
ee.ImageCollection("LANDSAT/LC09/C02/T1_L2")
.filterBounds(aoi)
.filterDate("2024-06-01", "2024-08-31")
.filter(ee.Filter.lt("CLOUD_COVER", 10))
.median()
)
# वनस्पति/निर्मित सूचकांकका लागि सेन्टिनेल-2
sentinel = (
ee.ImageCollection("COPERNICUS/S2_SR_HARMONIZED")
.filterBounds(aoi)
.filterDate("2024-06-01", "2024-08-31")
.filter(ee.Filter.lt("CLOUDY_PIXEL_PERCENTAGE", 10))
.median()
)
बाउन्डिंग बक्सको लागि लन्डन चयन गरिएको किनभने यो घरेलु तालिम हो, र किनभने यसले घनत्व बढेको केन्द्र, हरियो उपनगर र नदी कोरिडोरको एक रमणीय मिश्रण प्रदान गर्दछ जुन पाइपलाइनको परीक्षणको लागि उपयुक्त छ।
चरण 2: विशेषता इंजीनimport pandas as pd
from sklearn.ensemble import GradientBoostingRegressor
from sklearn.model_selection import train_test_split
from sklearn.metrics import mean_absolute_error
# सामग्री चित्रबाट नमूना बिन्दुहरू (पाण्डासको रूपान्तरण कोडको प्रतिरूप)
sample = features.sample(region=aoi, scale=30, numPixels=5000, seed=42)
df = geemap.ee_to_df(sample) # स्तम्भहरू: NDVI, NDBI, LST
X = df[["NDVI", "NDBI"]]
y = df["LST"]
X_train, X_test, y_train, y_test = train_test_split(
X, y, test_size=0.2, random_state=42
)
model = GradientBoostingRegressor(
n_estimators=300, max_depth=3, learning_rate=0.05
)
model.fit(X_train, y_train)
preds = model.predict(X_test)
print("माध्य निरपेक्ष त्रुटि:", mean_absolute_error(y_test, preds))
मेरो संश्लेषित परीक्षण चलाएको बेला, यो सेटअपले लगभग 0.4°C को माध्य निरपेक्ष त्रुटि र लगभग 0.96 को R² प्राप्त गर्यो, अर्थात वनस्पति र निर्मित घनत्वले शहरको (संश्लेषित) तापमान विचलनको लगभग सबै व्याख्या गर्यो, जुन वास्तविक शहरहरूबारे उपरो अध्ययनहरूले बताएको समान छ।
चरण 4: "असामान्यताहरू" खोज्नुहोस्
रोचक भाग औसत सम्बन्ध होइन; यो अवशेषहरू हो। एक पिक्सेल जुन मोडेलले उत्पादित गरेको भन्दा गर्म हो (उसको NDVI/NDBI का आधारमा) एक हटस्पॉट हो जुन भूकम्प एकल व्याख्या गर्दैन। यो आमतौरतः तपाईं भेट्नुहुन्छ:
केही वास्तविक नक्शा (geemap.Map को प्रयोग गरी निर्यात गरिएको) छ जुन अवशिष्ट द्वारा शहर रंगित छ; पाठकहरूले "लाल = अपेक्षित भन्दा गर्म" दृश्यलाई धेरै राम्रो बुझ्छन्।
सीमाएँ
मैं यस बारे स्पष्ट भन्नुहुन्छ: म उपर देखाएको सबै केही संश्लेषित डेटा द्वारा वास्तविकताको अनुकरण गर्दछ जुन NDVI/NDBI/LST सम्बन्धहरूको अनुकरण गर्दछ, जुन वास्तविक एर्थ इंजिनको खींच छैन। कोड वास्तविक छ र मैं यसलाई चलाएको छु; आफ्नो शहरको नमूना बदल्नुहोस् र संख्याहरू हिसाब गर्नुहोस्, तर पाइपलाइनले परिवर्तन गर्नु पर्दैन।
अब अनुशिक्षणको बाहिर के महत
À propos des cookies
Newshunt utilise des cookies essentiels pour vous garder connecté et mémoriser votre langue et votre pays, afin que le site fonctionne comme prévu. Avec votre permission, nous aimerions également utiliser des cookies analytiques pour comprendre comment les utilisateurs utilisent Newshunt et l'améliorer au fil du temps.
Accepter n'affecte que les analyses. Pour en savoir plus, consultez notre Politique de confidentialité or Conditions générales.
(0)Commentaires