डिक्टेशनको लागि कम-लेटेन्सी स्पीच-टु-टेक्स्ट पाइपलाइन डिजाइन गर्दै
श्रेणी: Entertainment
साझा गर्नुहोस्
अभिलेख
मनपर्यो
अगस्ट १७, २०२६ मा, विस्प्रले २ अर्ब डलरको मूल्याङ्कनमा २८० मिलियन डलर उठायो। दुई दिन पछि, द न्यू योर्क टाइम्स म्यागजिनले "सबैजना यो एआई डिक्टेशन एप प्रयोग गर्दैछ जुन म हथौडासँग मर्डर गर्न चाहन्छु" शीर्षक अन्तर्गत यसको डिक्टेशन एपको समीक्षा प्रकाशित गर्यो।
कोष कभरेजमा गाडिएको थप रोचक विवरण थियो: Wispr ले कठिन परिस्थितिहरू - आवाज, उच्चारण, संगीत - मा त्रुटि दरहरू ३०% भन्दा माथि स्वीकार गर्यो र त्यसलाई कम गर्न नयाँ मोडेलको पूर्वावलोकन गर्यो। त्यसैले समीक्षकको निराशा र कम्पनीको आफ्नै निदान एकै हप्तामा अवतरण भयो।
कुरा यहाँ छ। प्रयोगकर्ताहरूले "यो श्रुतलेखन एप खराब छ" भनेर अनुभव गर्ने धेरैजसो कुराहरू महिनौं अघि कसैले गरेको वास्तुकलाको निर्णयमा आधारित हुन्छन्, एउटा शब्द पनि ट्रान्सक्राइब हुनुभन्दा पहिले। तपाईंले एउटा नबनाउँदासम्म श्रुतलेखन समाधान भएको समस्या जस्तो देखिन्छ, र त्यसपछि तपाईंले पत्ता लगाउनुहुन्छ कि स्पष्ट छनौटहरू प्रायः गलत छन्।
यो पोस्ट त्यो निर्णयको बारेमा हो। चार वास्तुकलाहरू, प्रत्येकको वास्तवमा लागत कति छ, र प्रत्येक कहाँ बिग्रन्छ।
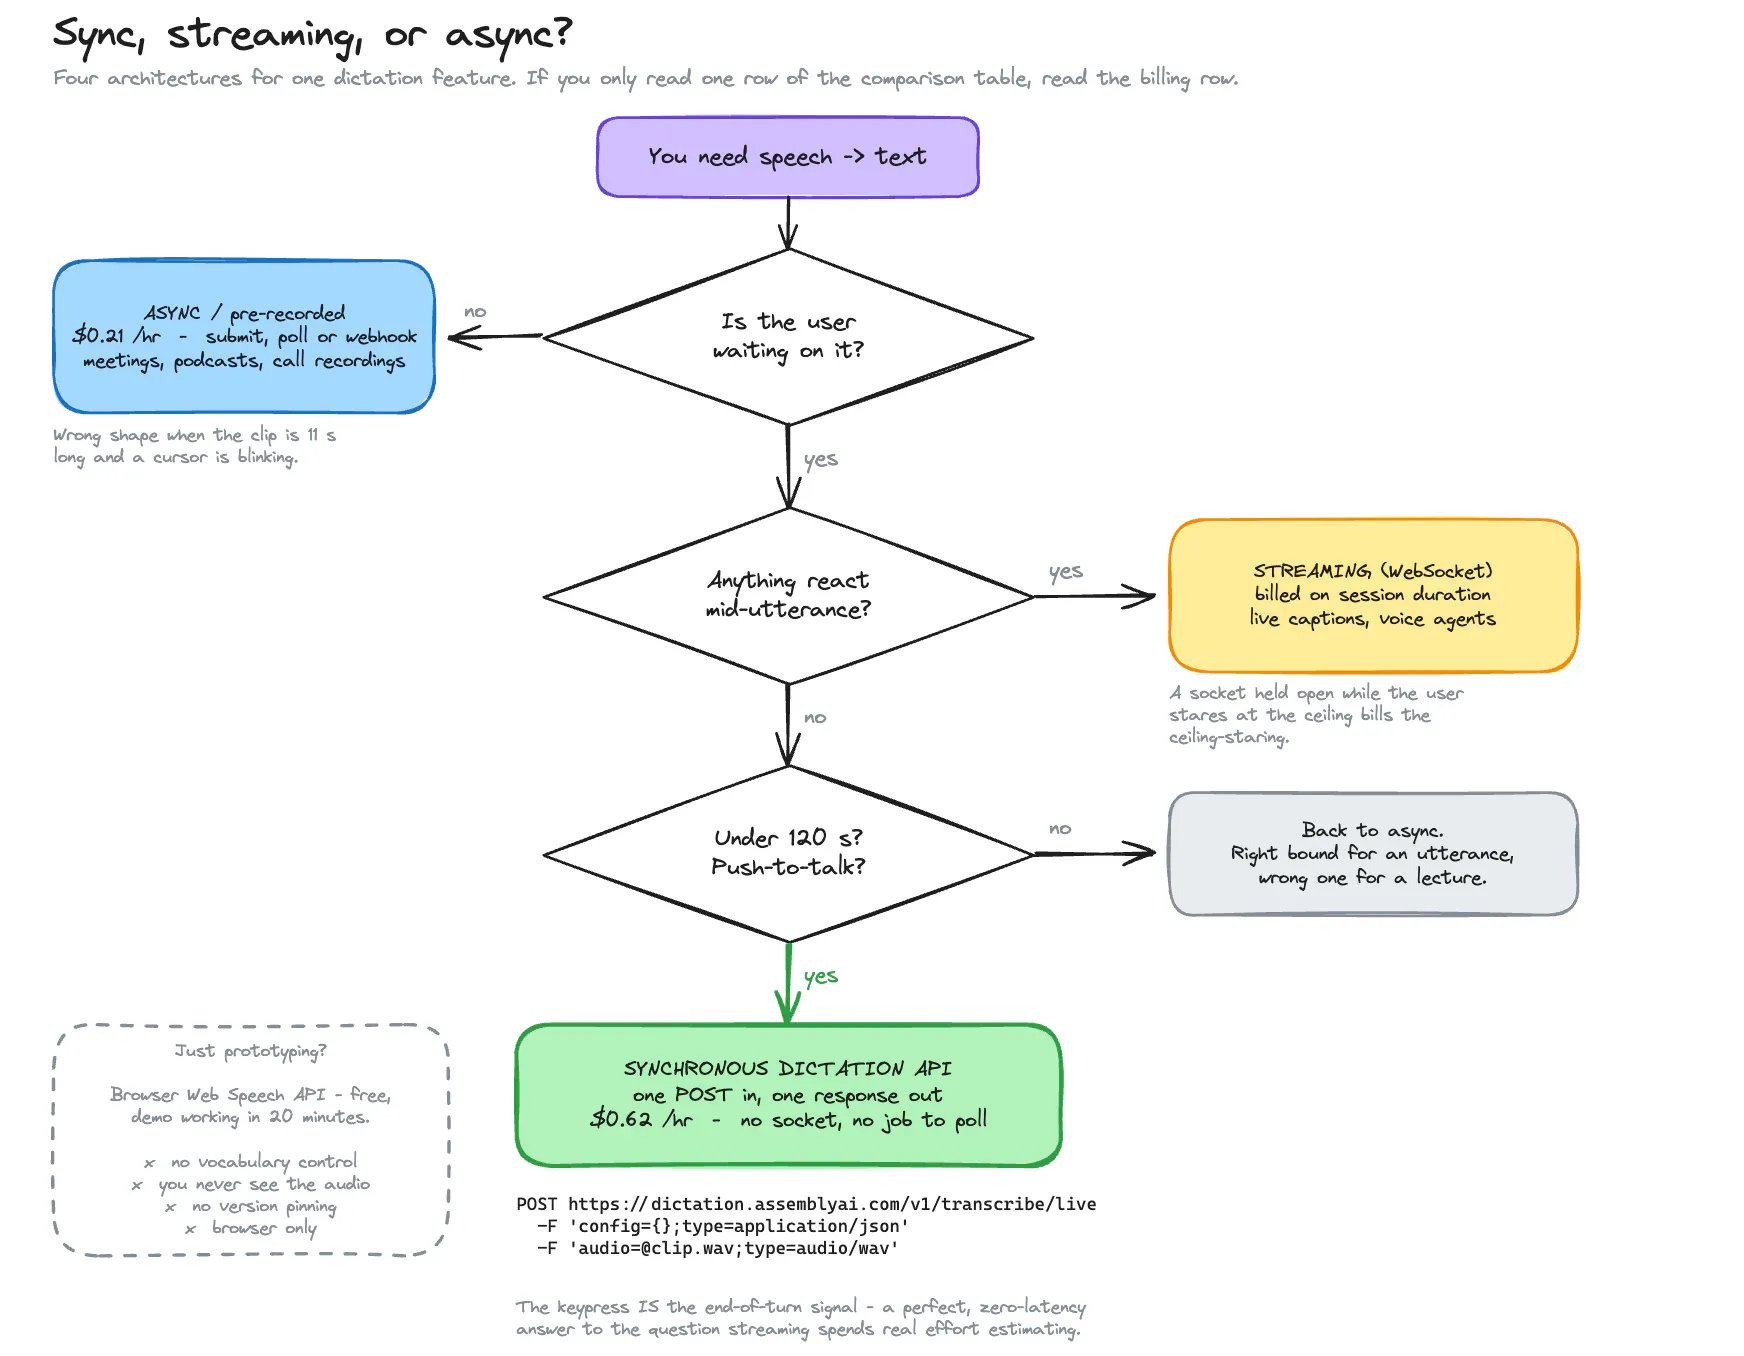
चार विकल्पहरू, सँगसँगै
उत्पादनको लागि ब्राउजर वेब स्पीच एपीआईका सीमितताहरू के के हुन्?
यो नि:शुल्क छ, यो ब्राउजरसँग पठाइन्छ, र तपाईंले बीस मिनेटमा डेमो काम गर्न सक्नुहुन्छ। प्रोटोटाइपको लागि, यसलाई प्रयोग गर्नुहोस्। उत्पादनको लागि, बाधाहरू छिटो बढ्छन्।
इमानदार सारांश: वेब स्पीच एपीआई तपाईंको प्रयोगकर्ताहरूले श्रुतलेखन चाहन्छन् कि चाहँदैनन् भनेर पत्ता लगाउने एक राम्रो तरिका हो, र एक पटक उनीहरूले गरेपछि तिनीहरूलाई सेवा दिने खराब तरिका हो।
स्ट्रिमिङ किन सामान्यतया गलत पूर्वनिर्धारित हुन्छ
यो गल्ती म प्रायः देख्छु, र यो बुझ्न सकिने गल्ती हो। डिक्टेशन वास्तविक-समय जस्तै हो, स्ट्रिमिङ API हरू वास्तविक-समय चीजहरूको लागि हुन्, त्यसैले विकासकर्ताहरू WebSocket को लागि पुग्छन्।
तर स्ट्रिमिङले तपाईंलाई के दिन्छ हेर्नुहोस्: वक्ताले बोल्दा अद्यावधिक हुने आंशिक परिकल्पनाहरू, र कहिले रोकिन्छ भनेर पत्ता लगाउने पालोको अन्त्य पत्ता लगाउने। दुवै साँच्चै मूल्यवान छन् - लाइभ क्याप्सनहरूको लागि, भ्वाइस एजेन्टको लागि जसले तपाईंले आफ्नो वाक्य समाप्त गर्नु अघि सोच्न सुरु गर्नुपर्छ। युनिभर्सल-३.५ प्रो रियलटाइम ती कार्यभारहरूको लागि ठ्याक्कै अवस्थित छ।
डिक्टेसनको आवश्यकता पनि पर्दैन। तपाईंको प्रयोगकर्ताले कुञ्जी थिचिरहेको छ। कि थिच्नु भनेको टर्न-अफ-टर्न सिग्नल हो — तपाईंसँग प्रश्नको लागि एक उत्तम, शून्य-विलम्बता उत्तर छ जुन स्ट्रिमिङले वास्तविक इन्जिनियरिङ प्रयास अनुमान गर्न खर्च गर्छ। र कोही पनि पाठ फ्लिकर भएको हेर्न र उनीहरूले रचना गरिरहेको स्ल्याक सन्देश भित्र आफैलाई पुन: लेख्न चाहँदैनन्। उनीहरू समाप्त वाक्य चाहन्छन्।
त्यसोभए तपाईंले दुई सुविधाहरूको लागि भुक्तानी गरिरहनुभएको हुनेछ र ती मध्ये कुनै पनि प्रयोग गरिरहनुभएको हुनेछैन। शाब्दिक रूपमा भुक्तानी गर्दै: स्ट्रिमिङको बिल सत्र अवधिमा गरिन्छ — वेबसकेट कति समय खुला छ — तपाईंले कति अडियो पठाउनुभयो भन्ने आधारमा होइन। प्रयोगकर्ताले आफ्नो विचार लेख्दै छतमा हेर्दा सकेट खुला राख्ने डिक्टेशन एपले छतलाई हेर्दै बिलिङ गरिरहेको हुन्छ।
बोलीको बीचमा प्रतिक्रिया दिने कार्यभारहरूको लागि स्ट्रिमिङ गरिरहनुहोस्। पुश-टु-टकको लागि, यो सस्तो चीज निर्माण गर्ने महँगो तरिका हो।
किन एसिन्क्रोनस पनि ठीक छैन?
पूर्व-रेकर्ड गरिएको ट्रान्सक्रिप्शनले बिलिङ समस्या समाधान गर्छ — तपाईंले अडियो अवधिको लागि भुक्तानी गर्नुहुन्छ, र युनिभर्सल-३.५ प्रो $०.२१/घण्टा चल्छ। यो बैठक, पोडकास्ट र कल रेकर्डिङको लागि सही कल हो।
बेमेल भनेको अन्तरक्रिया मोडेल हो। एसिन्क्रोनस एपीआईहरू काम-सबमिशन प्रणालीहरू हुन्: फाइल अपलोड गर्नुहोस्, आईडी प्राप्त गर्नुहोस्, मतदान गर्नुहोस् वा वेबहुकमा पर्खनुहोस्। अडियो चालीस मिनेट लामो हुँदा र प्रयोगकर्ता पर्खिरहेको नभएको बेला त्यो डिजाइन सही हुन्छ। अडियो एघार सेकेन्ड लामो हुँदा र कोही झिम्किरहेको कर्सरलाई हेरिरहेको बेला यो गलत आकार हुन्छ।
तपाईंले यसलाई काम गर्न सक्नुहुन्छ। तपाईंले कामको क्युबाट अनुरोध-प्रतिक्रिया API निर्माण गर्नुहुन्छ, जुन जानाजानी गर्नु अनौठो कुरा हो।
त्यसो भए: सिङ्क, स्ट्रिमिङ, वा एसिन्क्रोनस?
पुश-टु-टक डिक्टेशनको लागि, सिंक्रोनस अनुरोध प्रयोग गर्नुहोस्। एउटा उच्चारण भित्र, एउटा प्रतिक्रिया बाहिर, व्यवस्थापन गर्न कुनै जडान छैन र मतदान गर्न कुनै काम छैन।
डिक्टेशन एपीआई भनेको यही हो — एउटा मात्र पोस्ट, सेप्टेम्बर १५, २०२६ मा जारी गरिएको:
त्यो अन्तिम बाधा पनि त्यो विशेषता हो, जसले हामीलाई विलम्बतामा ल्याउँछ।
कि थिच्ने देखि समाप्त पाठ सम्मको सबैभन्दा कम विलम्बता मार्ग के हो?
चार कुराहरू, तिनीहरूले तपाईंलाई कतिमा किन्छन् भन्ने मोटामोटी क्रममा।
प्रयोगकर्ताले कुरा गरिरहेको बेला अपलोड गर्नुहोस्। किनकि सर्भरले आफूसँग भएको कुरा ट्रान्सक्राइब गर्छ जब बाँकी आउँछ, रेकर्डिङको समयमा अडियो स्ट्रिम गर्ने क्लाइन्टले पछि अपलोडको लागि पर्खिरहेको हुँदैन। प्रयोगकर्ताले बोल्न बन्द गरेपछि अडियोको अन्तिम अंशको लागि पर्खिरहेको हुन्छ, सम्पूर्ण क्लिप होइन। कच्चा PCM यहाँ सबैभन्दा सजिलो छ — अन्तिम रूप दिन कुनै कन्टेनर हेडर छैन, त्यसैले फ्रेमहरू माइक्रोफोनबाट बाहिर निस्कँदा तारमा जान्छन्:
दुई-सेकेन्डको उच्चारणको अगाडि DNS, TCP, र TLS कुल प्रतीक्षाको अर्थपूर्ण अंश हो। त्यहाँ एउटा GET /warm अन्त्य बिन्दु छ जसले तपाईंको HTTP क्लाइन्टको पूलमा खुला जडान छोड्ने बाहेक केही गर्दैन:
उही HTTP क्लाइन्ट र उही होस्ट, र निष्क्रिय जडानहरू केही सेकेन्ड पछि हटाइन्छ — अनुरोधको केही समय अघि यति न्यानो हुन्छ, अनुप्रयोग सुरु गर्दा होइन। (यदि तपाईंलाई विवरणहरू चाहिन्छ भने हामीले चरण-दर-चरण निर्माण गाइडमा पूर्ण पूर्व-वार्मिंग प्रविधि लेखेका छौं।)
यदि तपाईं आफैंले समय मिलाउन चाहनुहुन्छ भने आफ्नो नि:शुल्क API कुञ्जी प्राप्त गर्न लगभग एक मिनेट लाग्छ: assemblyai.com/dashboard/signup ।
श्रुतलेखन API लाई नियमित स्पीच-टु-टेक्स्ट API भन्दा के फरक बनाउँछ?
यसले एउटाको सट्टा दुई चीजहरू फर्काउँछ।
ट्रान्सक्रिप्शन API ले तपाईंलाई बोलिएका शब्दहरू दिन्छ। श्रुतलेखन API ले तपाईंलाई बोलिएका शब्दहरू र तपाईंको प्रयोगकर्ताले वास्तवमा लेख्न चाहेको पाठ दिन्छ:
तह ३ समाधान भएको छैन, र म तर्क गर्छु कि यो डिक्टेशन तहमा बस्नु हुँदैन। तर तह १ र २ निरन्तर मिसिन्छन् — समीक्षकहरू सहित, जसले तीनवटै एकैचोटि असफल भएको अनुभव गर्छन् र यसलाई "ट्रान्सक्रिप्शन खराब छ" भनेर फाइल गर्छन्।
तीनवटा छुट्टाछुट्टै नबहरूले यसलाई नियन्त्रण गर्छन्, र तिनीहरूलाई मिसाउनु निराशाको एक सामान्य स्रोत हो:
पहिलो दुईले मोडेलले सुनेको कुरालाई निर्देशित गर्छ। तेस्रोले पहिले नै सुनेको कुरालाई पुन: आकार दिन्छ। जतिसुकै llm_instruction ले पनि गलत सुनेको शब्दलाई ठीक गर्दैन — धाराप्रवाह गलत उत्तर गन्दा सही उत्तर भन्दा खराब हुन्छ, र हामीले श्रुतलेखन सफाईको बारेमा छुट्टै पोस्टमा त्यो असफलता मोडमा गहिरोसँग गएका छौं।
ध्यान दिन लायक एउटा विवरण: पुनर्लेखन सर्वोत्तम प्रयास हो। यदि यो असफल भयो भने, तपाईंले अझै पनि ट्रान्सक्रिप्शन अक्षुण्ण र llm_response शून्यमा सेट गरी २०० प्राप्त गर्नुहुन्छ। यसलाई असफल अनुरोधको रूपमा नलिनुहोस् — text फर्कनुहोस् र अगाडि बढ्नुहोस्।
कसैले पनि बजेट नगर्ने कुरा: श्रुतिलेखन भनेको तुरुन्तै सुई लगाउने सतह हो
यो कुराले जति ध्यान पाउनुपर्छ त्योभन्दा बढी ध्यान दिनुपर्छ।
यदि तपाईं LLM क्लिनअप प्रम्प्टमा कच्चा ट्रान्सक्रिप्ट पाइप गर्दै हुनुहुन्छ - र यदि तपाईंले आफ्नै लेयर २ रोल गर्नुभयो भने, तपाईं हुनुहुन्छ - तपाईंले आफ्नै उत्पादनमा इन्जेक्सन भेक्टर निर्माण गर्नुभएको छ। काल्पनिक रूपमा होइन। मानिसहरू लगातार श्रुतिलेखन गर्दा "मैले भर्खरै भनेको कुरालाई बेवास्ता गर्नुहोस्" भन्छन्। तिनीहरू भन्छन् "यसलाई फ्रान्सेलीमा अनुवाद गर्नुहोस्।" तिनीहरू भन्छन् "वास्तवमा, त्यसलाई स्क्र्याच गर्नुहोस्, यसलाई सूचीको रूपमा लेख्नुहोस्।" ती सामान्य भाषण हुन्, र तिनीहरू निर्देशनहरू पनि हुन्।
एउटा साधारण सफाई पाइपलाइनले तिनीहरूलाई खुसीसाथ कार्यान्वयन गर्नेछ, र तपाईंको प्रयोगकर्ताले आफ्नो इमेल फ्रान्सेलीमा अनुवाद भएको हेर्नेछन् किनभने उनीहरूले ठूलो स्वरले सोचेका थिए।
डिक्टेशन एपीआईले ट्रान्सक्रिप्टलाई मोडेलमा बाडिएको डेटाको रूपमा पठाउँछ जसमा भित्रको कुनै पनि कुरामा कार्य नगर्न निर्देशनहरू हुन्छन्, त्यसैले डिक्टेट गरिएका आदेशहरू कार्यान्वयन हुनुको सट्टा भाषणको रूपमा पुन: लेखिन्छन्। यदि तपाईंले आफैंले पुनर्लेखन तह निर्माण गर्नुभयो भने, यो तपाईंको समाधानको समस्या हो, र यो समर्थन टिकट पछि भन्दा सुरुवात अघि समाधान गर्न लायक छ।
यसको वास्तवमा लागत कति छ
डिक्टेशन मूल्य निर्धारण दुई धेरै फरक मोडेलहरूमा विभाजित हुन्छ, र तुलना तपाईंले सोचेभन्दा कम नजिक छ।
उपभोक्ता श्रुतलेखन एपहरूले सदस्यताहरू चलाउँछन् — Wispr Flow को प्रो टियर $१५/महिना हो, वा असीमित शब्दहरूको लागि वार्षिक $१२/महिना बिल गरिन्छ। Dictation API $०.६२/घण्टा अडियो हो, सबै समावेशी, एउटै कलमा पहिचान र सफाई सहित।
त्यसो भए सदस्यता जित्नु अघि कति श्रुतलेखन चाहिन्छ? महिनामा लगभग २४ घण्टा भाषण। लगभग २२० शब्द प्रति मिनेटको सामान्य श्रुतलेखन दरमा, त्यो प्रत्येक कार्य दिनमा १४,००० शब्दहरूको उत्तरमा कतै हो - लेखिएको छैन, माइक्रोफोनमा बोलिएको छैन , हरेक दिन, महिनाभरि।
वास्तविक भारी प्रयोग फरक देखिन्छ। कमिट सन्देशहरू, स्ल्याक, र कोड टिप्पणीहरूमा प्रति दिन ३,००० शब्दहरू लेख्ने विकासकर्ताले दिनको लगभग १४ मिनेट, वा महिनाको पाँच घण्टा बोलिरहेको हुन्छ। त्यो लगभग $३.१० हो। मध्यम प्रयोग एक डलरको नजिक पुग्छ।
मुख्य कुरा यो होइन कि सदस्यताहरू ठगी हुन्। यो यो हो कि सदस्यताको मूल्य कहिल्यै ट्रान्सक्रिप्शनको विरुद्धमा निर्धारण गरिएको थिएन - यो एप, सिङ्किङ, पोलिश, र अरू कसैले यसलाई कायम राख्छ भन्ने तथ्यको विरुद्धमा मूल्य निर्धारण गरिएको छ। जुन भुक्तानी गर्न पूर्ण रूपमा उचित कुरा हो, जबसम्म तपाईं आफ्नो उत्पादन भित्र श्रुतलेखन चाहनुहुन्न, जहाँ प्रति-घण्टा संख्या महत्त्वपूर्ण हुन्छ।
तपाईंले पढ्न सक्ने सन्दर्भ कार्यान्वयन
यदि तपाईं स्पेक भन्दा काम गर्ने कोड पढ्न चाहनुहुन्छ भने, Blurt एउटा खुला-स्रोत macOS श्रुतलेखन एप हो जुन यस API मा निर्मित छ — MIT लाइसेन्स प्राप्त, नेटिभ AppKit र SwiftUI, कुनै इलेक्ट्रोन छैन। एउटा कुञ्जी होल्ड गर्नुहोस्, बोल्नुहोस्, र पाठ तपाईंले टाइप गरिरहनुभएको जुनसुकै एपमा जान्छ। तपाईं आफ्नै API कुञ्जी ल्याउनुहुन्छ, र सम्पूर्ण अडियो मार्ग एकल POST हो जुन तपाईं रिपोमा अन्त्यदेखि अन्त्यसम्म पढ्न सक्नुहुन्छ।
यो नयाँ छ, र यो पोलिश गरिएको उत्पादनको सट्टा सन्दर्भ कार्यान्वयन हो। यो बरु मुख्य कुरा हो - यो अवस्थित छ ताकि तपाईंले वास्तुकलामा प्रतिबद्ध हुनु अघि टुक्राहरू कसरी फिट हुन्छन् भनेर ठ्याक्कै देख्न सक्नुहुन्छ।
हथौडा मा फर्कनुहोस्
समीक्षकको गुनासो वास्तविक थियो। उनको ट्रान्सक्रिप्टहरूलाई उनले जति सुरक्षित गरेकी थिइन् त्यति नै सम्पादन आवश्यक थियो, र उनले प्रविधि तयार नभएको निष्कर्ष निकालिन्।
तर उनी तीन फरक असफलताहरू वर्णन गर्दै थिइन् र तिनीहरूलाई एउटा भनिरहेकी थिइन्। ती मध्ये केही पहिचान थियो, जुन मापनयोग्य छ र नाटकीय रूपमा राम्रो भएको छ। ती मध्ये केही सफाई तह थियो, जुन धेरैजसो एपहरूले ट्रान्सक्रिप्शन एपीआई र प्रम्प्टबाट आफैं निर्माण गरिरहेका थिए, जुन ठ्याक्कै त्यहीं हो जहाँ गुणस्तर घट्छ र किन प्रयोगकर्ताहरूले प्रतिगमनहरू देख्न थाले। र यसको केही - बोली लेख्न नसक्ने बारे, एपले विचारलाई पुनर्गठन गर्न असमर्थ भएको बारे - एक वास्तविक, समाधान नगरिएको समस्या हो जुन कुनै पनि ट्रान्सक्रिप्शन मोडेलले समाधान गर्न गइरहेको छैन।
त्यो अन्तिम कुरा बस्न लायक छ। हामीले मानिसहरूलाई सही रूपमा सुन्न र उनीहरूको भाषणलाई गद्य जस्तै पढ्नमा राम्रोसँग सिकेका छौं। बोलिएको रम्बललाई राम्रोसँग संरचित तर्कमा परिणत गर्नु फरक समस्या हो, र मलाई लाग्दैन कि यो श्रुतलेख तहमा पर्छ। यो जहाँ लेखिन्छ त्यहाँ सम्बन्धित छ।
जसको अर्थ अर्को वर्ष श्रुतलेखनमा हुने रोचक काम सम्भवतः मोडेलमा छैन। यो सम्पादक कहाँ बस्छन् भनेर पत्ता लगाउने कुरामा छ।
कुकीहरू बारे जानकारी
Newshunt ले तपाईंलाई साइन इन राख्न र तपाईंको भाषा र देश सम्झन आवश्यक कुकीहरू प्रयोग गर्दछ, ताकि साइट तपाईंले अपेक्षा गरेअनुसार काम गरोस्। तपाईंको अनुमतिमा, हामी Newshunt लाई मानिसहरूले कसरी प्रयोग गर्छन् भन्ने बुझ्न र समयसँगै सुधार्न एनालिटिक्स कुकीहरू पनि प्रयोग गर्न चाहन्छौं।
स्वीकार गर्नाले एनालिटिक्समा मात्र असर पार्छ। थप जान्नका लागि, हाम्रो हेर्नुहोस् गोपनीयता नीति or नियम र शर्तहरू.
(0)टिप्पणीहरू